Qwen3.8 : ce que la nouvelle famille d’Alibaba change pour l’IA locale en entreprise
Qwen3.8-27B, publié le 14 août 2026 sous Apache 2.0 : multimodal, 262 000 jetons de contexte et des benchmarks en forte hausse. Ce qu’il change pour une PME.
Ce qui vient de se passer, en trois dates
Le 3 août 2026, Alibaba lançait Qwen3.8-Max en API, avec un billet au titre ambitieux (« A New Bar for Coding and Cowork »). Le 12 août, l’équipe Qwen publiait les poids du géant de la famille : Qwen3.8-2.4T-A95B, premier modèle de calibre « Max » de la série à être offert en téléchargement. Et le 14 août à 15 h UTC, après deux jours de retard sur le calendrier annoncé qui ont fait couler beaucoup d’encre, le dépôt officiel de Qwen3.8-27B apparaissait sur Hugging Face, licence Apache 2.0 en tête de fiche.
L’accueil ne s’est pas fait attendre : plus de 600 000 téléchargements du 27B sur Hugging Face en deux jours (versions standard et FP8 confondues) et l’un des fils Hacker News les plus actifs de l’été (plus de 1 300 points). C’est le successeur direct de Qwen3.6-27B, le modèle que nous recommandons par défaut depuis notre comparatif des modèles locaux : la question de la mise à niveau se pose donc concrètement pour toute entreprise qui héberge son IA.
Cet article trie ce qui est établi, ce qui est prometteur et ce qui reste à vérifier. Chaque chiffre est attribué à sa source; les scores officiels d’Alibaba sont identifiés comme tels, parce qu’aucune réplication indépendante n’existait au moment d’écrire ces lignes.
Qwen3.8-27B : la vraie nouvelle pour une PME
Sur le papier, le 27B coche toutes les cases du serveur d’entreprise. Licence Apache 2.0 sans restriction commerciale, comme son prédécesseur. Multimodalité native dès le lancement : le modèle accepte texte, images et vidéo en entrée, ce qui ouvre la lecture de plans, de bordereaux numérisés et de schémas sans modèle spécialisé à côté. Contexte natif de 262 144 jetons, extensible à un million par la méthode YaRN, avec la réserve d’usage : la fiche technique reconnaît que cette extension statique peut dégrader légèrement les performances sur les contextes courts.
L’architecture change en profondeur : 27,8 milliards de paramètres répartis en 64 couches hybrides, dont 48 couches d’attention linéaire Gated DeltaNet et 16 couches d’attention classique. C’est le même virage que toute l’industrie chinoise des grands modèles prend en 2026 et il vise précisément le point faible des modèles denses : le coût mémoire du long contexte. Le modèle est livré en un seul point de contrôle post-entraîné, avec un mode de raisonnement réglable (trois niveaux d’effort) et un mode direct pour les réponses courtes.
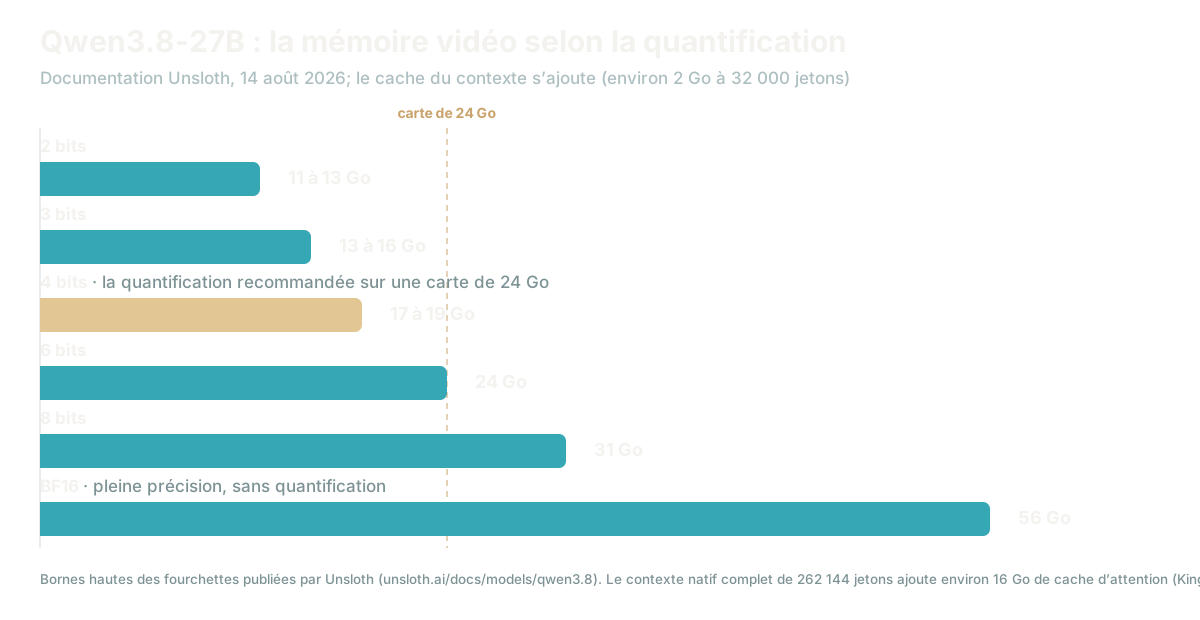
Côté matériel, la documentation d’Unsloth situe la quantification 4 bits entre 17 et 19 Go de mémoire vidéo et la version 6 bits à 24 Go. Une carte de 24 Go fait donc tourner le 27B en Q4 avec un contexte de travail d’environ 32 000 jetons, cache d’attention compris. Le contexte natif complet est une autre histoire : environ 16 Go de cache supplémentaires selon l’analyse de Kingy AI. Autrement dit, le serveur qui faisait tourner Qwen3.6-27B fait tourner Qwen3.8-27B, au même palier de crédit d’impôt C3I pour le matériel.
Des benchmarks impressionnants, à lire pour ce qu’ils sont
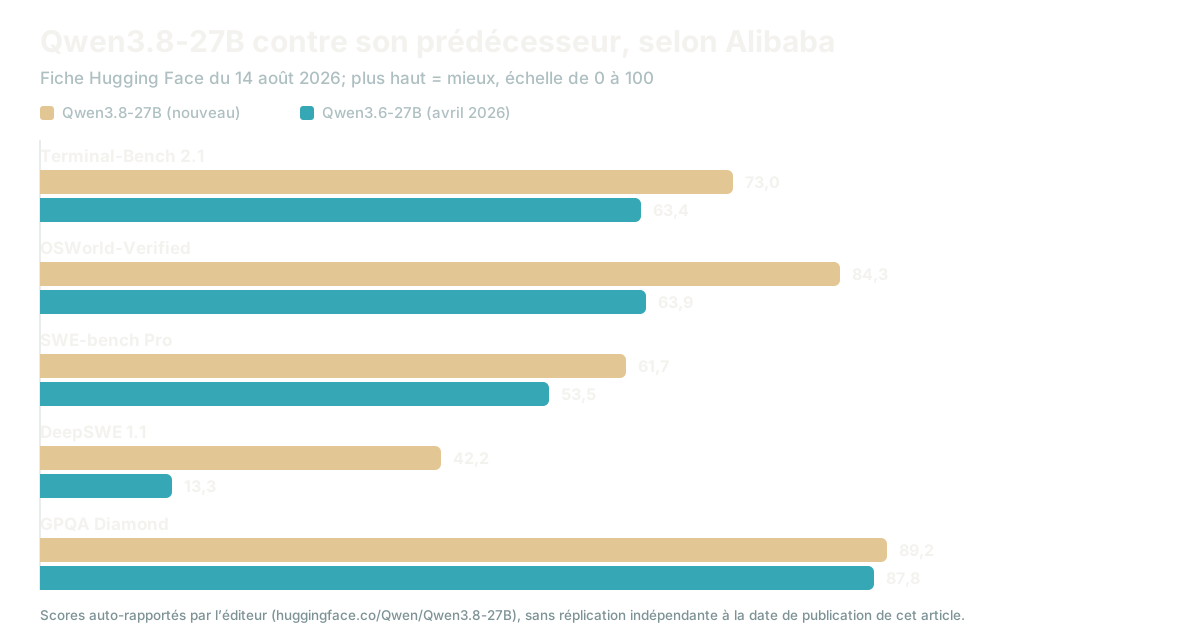
Les chiffres publiés par Alibaba montrent un saut générationnel réel sur les tâches d’agent : 73,0 au Terminal-Bench 2.1 contre 63,4 pour Qwen3.6-27B, 61,7 contre 53,5 au SWE-bench Pro, 84,3 contre 63,9 à OSWorld-Verified et un triplement au test DeepSWE 1.1 (42,2 contre 13,3). Les scores de connaissances progressent plus modestement (89,2 contre 87,8 au GPQA Diamond). Pour un modèle qui vise les flux d’agents en entreprise, c’est exactement le profil de progression qu’on veut voir.
Trois mises en garde avant d’en tirer des conclusions. Un, tous ces chiffres sont auto-rapportés par Alibaba dans la fiche du modèle : aucune réplication indépendante n’était disponible au moment d’écrire ces lignes et l’analyse de Kingy AI rappelle que les comparaisons aux modèles commerciaux n’ont pas été exécutées dans des conditions identiques. Le cadrage viral « il bat les grands modèles fermés » repose sur une sélection de tests choisie par le vendeur. Deux, les premiers retours de terrain signalent une tendance au sur-raisonnement : le mode de réflexion peut s’étirer longuement sur des tâches simples si on ne le bride pas, un défaut de famille déjà noté chez Qwen3.6. Trois, la prise en charge de la vision dans les outils locaux (llama.cpp et ses dérivés) était encore en rodage au lancement : la multimodalité sur votre serveur peut demander quelques semaines de maturité logicielle.
Sur l’API commerciale, la version Max de la famille obtient de son côté un Intelligence Index de 58 chez Artificial Analysis, dixième rang mondial au moment du relevé, avec un débit jugé lent (47 jetons par seconde) et une verbosité marquée. C’est le seul chiffrage indépendant de la famille à ce jour et il confirme le portrait : très fort, pas magique.
Le 2.4T : un événement pour le marché, pas pour votre serveur
L’autre publication d’août est spectaculaire sur le papier : 2 400 milliards de paramètres au total, 95 milliards activés par jeton, 512 experts, attention hybride et contexte extensible à un million de jetons. C’est le premier modèle de calibre « Max » que Qwen offre en téléchargement. Mais les ordres de grandeur le disqualifient d’emblée pour une entreprise : 4,9 To de mémoire en pleine précision d’après la fiche du dépôt et encore environ 400 Go dans la quantification la plus brutale disponible. Comme l’a résumé un commentaire du fil Hacker News, c’est « un objet de salle de serveurs », pensé pour les fournisseurs d’infonuagique et les laboratoires.
La licence mérite tout de même l’attention, parce qu’elle marque un tournant. Contrairement au 27B, le 2.4T abandonne Apache 2.0 pour une licence maison : mention du modèle obligatoire dans l’interface au-delà de 100 millions d’utilisateurs mensuels ou de 20 millions de dollars américains de revenus mensuels et licence commerciale séparée pour offrir le modèle en service au-delà de 50 millions de dollars de revenus sur douze mois. L’usage interne est explicitement exempté : aucune PME n’est concernée par ces seuils. Le signal est ailleurs : les grands laboratoires chinois convergent vers des licences qui protègent leurs revenus d’API; l’époque du tout-Apache pour les modèles géants se referme.
Détail révélateur : les poids ouverts du 2.4T sont texte seulement et en mode raisonnement seulement. La vision, le million de jetons en entrée et les outils intégrés restent l’exclusivité de l’API payante. La version qu’on télécharge n’est pas la version qu’on loue et la communauté l’a remarqué. Pour une entreprise, c’est un rappel utile : en IA locale, la fiche du dépôt fait foi, pas le communiqué de presse.
Apache 2.0
licence du 27B, sans restriction commerciale; le 2.4T passe, lui, à une licence maison à seuils
≈ 400 Go
mémoire minimale du 2.4T dans sa quantification la plus agressive : hors de portée d’un serveur de PME
600 000+
téléchargements du 27B sur Hugging Face en deux jours, versions standard et FP8 confondues
Et le français, dans tout ça
C’est l’angle mort de ce lancement et, pour une entreprise québécoise, le plus important. Ni la fiche du 27B ni celle du 2.4T ne publient de liste de langues prises en charge ni le moindre résultat multilingue détaillé : les benchmarks officiels sont annotés anglais et chinois. La revendication de 119 langues qui circule appartient à la génération Qwen3 d’avril 2025; rien ne permet de la transposer telle quelle à Qwen3.8.
L’expérience des générations précédentes incite à l’optimisme prudent : le français de Qwen3.5 et de Qwen3.6 est solide et il serait surprenant que Qwen3.8 régresse. Mais « surprenant » n’est pas un critère d’ingénierie. Avant de confier vos soumissions et vos contrats au nouveau venu, la seule méthode sérieuse est un banc d’essai sur vos propres documents : mêmes questions, mêmes extraits, réponses comparées à l’aveugle avec le modèle en place. C’est un exercice d’une journée et il tranche mieux que n’importe quel classement public.
Ce que nous recommandons à nos clients
Si votre assistant tourne déjà sur Qwen3.6-27B : rien ne presse. Votre matériel fait tourner le remplaçant le jour où vous le déciderez, la mise à niveau est un après-midi de travail et le gain annoncé porte surtout sur les tâches d’agent (exécuter des processus, manipuler des outils), moins sur la qualité de rédaction documentaire. Attendez les premières réplications indépendantes et testez sur votre corpus. Le sur-raisonnement se gère dès le premier jour en fixant le niveau d’effort de réflexion au minimum pour les tâches de routine.
Si vous démarrez un projet d’IA locale cet automne : évaluez les deux. Le 27B multimodal est prometteur pour tout flux qui lit des documents numérisés, des plans ou des photos de chantier, un besoin constant chez nos clients manufacturiers. Sa fiche est récente, son écosystème mûrit à vue d’œil (les fichiers GGUF communautaires sont apparus le jour même du lancement) et sa licence est irréprochable. Le choix final appartient au banc d’essai, pas à l’actualité.
Et si vous hésitez encore entre héberger et vous abonner, la question précède celle du modèle : notre argumentaire IA locale ou nuage public pose les termes juridiques et économiques du débat. Un modèle de plus dans le catalogue ouvert, aussi fort soit-il, ne change pas la conclusion : le modèle passe, l’infrastructure et les données restent.
Questions fréquentes
Qwen3.8-27B remplace-t-il Qwen3.6-27B comme choix par défaut?
Pas encore. Les gains annoncés sont réels sur le papier, mais tous les chiffres viennent d’Alibaba sans réplication indépendante, le comportement en français n’est pas documenté et le recul de terrain se compte en jours. Notre recommandation par défaut reste Qwen3.6-27B; le 27B de Qwen3.8 devient candidat au remplacement dès qu’un banc d’essai sur vos propres documents lui donne l’avantage.
Le modèle tient-il sur un GPU de 24 Go?
Oui, en quantification 4 bits : 17 à 19 Go selon la documentation d’Unsloth, ce qui laisse la place à un contexte de travail d’environ 32 000 jetons. Le contexte natif complet de 262 144 jetons est une autre affaire : le cache d’attention réclame alors environ 16 Go de plus, ce qui déclasse la carte de 24 Go. Pour la plupart des usages documentaires d’entreprise, 32 000 jetons suffisent largement.
Les scores « il bat les grands modèles fermés » sont-ils fiables?
À prendre avec précaution. Les comparaisons publiées par Alibaba ne sont pas exécutées dans des conditions identiques pour tous les modèles, portent sur une sélection de tests choisie par l’éditeur et n’avaient aucune réplication indépendante au moment du lancement. La seule mesure tierce disponible porte sur l’API Max de la famille : dixième rang mondial à l’Intelligence Index d’Artificial Analysis, avec un débit lent. Fort, donc, mais pas au point d’annuler l’écart avec les meilleurs modèles commerciaux sur les tâches les plus difficiles.
La licence maison du 2.4T est-elle un risque pour une entreprise?
Non pour une PME : l’usage interne est explicitement exempté et les seuils (100 millions d’utilisateurs mensuels, 20 millions de dollars américains de revenus mensuels pour l’attribution, 50 millions sur douze mois pour le service commercial) sont hors d’échelle. Le vrai enjeu est ailleurs : le 2.4T exige environ 400 Go de mémoire au strict minimum, ce qui le réserve aux centres de données. Le 27B, seul modèle pertinent pour une PME, reste sous Apache 2.0 sans réserve.
La vision du 27B fonctionne-t-elle déjà sur un serveur local?
En rodage. Le modèle est multimodal nativement, mais au lancement la prise en charge de la vision dans llama.cpp et les outils qui en dérivent n’était pas complète et l’entrée officielle au catalogue Ollama peut tarder. Les fichiers quantifiés communautaires sont apparus le jour même; comptez quelques semaines pour que la chaîne d’outils se stabilise avant de bâtir un flux de production sur la lecture d’images.
Faut-il changer de serveur pour passer à Qwen3.8-27B?
Non. Le gabarit mémoire est le même que celui de Qwen3.6-27B : un GPU de 24 Go couvre la quantification 4 bits avec un contexte de travail confortable. Un serveur acheté pour la génération précédente reste donc pleinement pertinent et le matériel demeure admissible au crédit d’impôt C3I dans les mêmes conditions.
Sources et références
- Fiche Hugging Face officielle de Qwen3.8-27B (spécifications, benchmarks, licence Apache 2.0)
- Fiche Hugging Face officielle de Qwen3.8-2.4T-A95B (architecture, poids texte seulement)
- Texte intégral de la licence maison du 2.4T (seuils d’attribution et de service commercial)
- Annonce officielle du 27B, équipe Qwen sur X (14 août 2026)
- Unsloth, documentation Qwen3.8 (mémoire requise par quantification, réglages recommandés)
- Kingy AI, analyse technique de Qwen3.8-27B (cache d’attention, conditions des benchmarks)
- Artificial Analysis, évaluation indépendante de Qwen3.8-Max (Intelligence Index, débit)
- MarkTechPost, disponibilité générale de Qwen3.8-Max (3 août 2026, prix de l’API)
- Fil Hacker News du lancement du 27B (retours de terrain, sur-raisonnement)
- Forkast, analyse de la licence du 2.4T (« a platform play, not a gift »)
- BigGo Finance, la convergence des méga-modèles chinois (Qwen3.8 et Kimi K3)
Cet article est une synthèse de vulgarisation, à jour à la date indiquée. Il ne constitue pas un avis juridique : pour votre situation particulière, consultez un conseiller juridique ou communiquez avec la Commission d’accès à l’information.
À lire ensuite
Souveraineté
Top 5 des modèles d’IA à héberger chez vous en 2026 : un comparatif honnête
Lire →
Stratégie
IA locale ou nuage public : l’argumentaire complet pour justifier votre choix
Lire →
Financement
Subventions IA au Québec en 2026 : qui paie quoi, et comment monter un dossier
Lire →
Une question sur votre propre conformité?
L’appel de qualification est gratuit et dure une demi-heure. Vous repartez avec une lecture honnête de votre situation.
Discutons-en